Data Vault auf Databricks
Die optimale Architektur für ein Lakehouse generiert ausgehend unverändert historisierten Quellsytemdaten per model-driven DWH-Automation alle Layer.
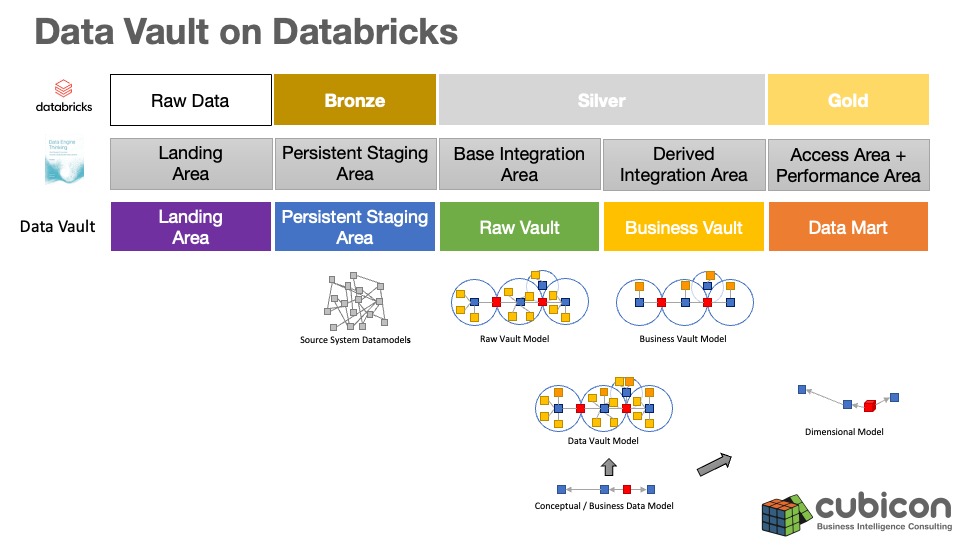
Das Lakehouse speichert Quellsystemdaten unverändert in einer persistierten Staging Area (PSA) und generiert über fachliche Metadaten die oberen Layer. Die Trennung von Quellsystemdaten, fachlicher Datenmodellierung und Geschäftslogik sorgt für eine skalierbare, agile, automatisierte Datenplattform, die mit den Anforderungen in großen Datenprojekten Schritt hält.
Der Artikel basiert auf meinem Vortrag "Data Vault auf Databricks" vom 1. Oktober 2026 auf der Data Vault Usergroup Tagung in Köln. Er beschreibt das Data Lakehouse, die Architektur sowie die fachliche Datenmodellierung, die das Fundament für model-driven Data Warehouse Automation bildet. Diese Lösung automatisiert alle Layer des Data Lakehouses. Für einen stabilen Betrieb empfehlen wir eine Zugriffsschicht, die den agilen Data Vault Integrationslayer von den abnehmenden Systemen entkoppelt.
Die Methoden und Technologien für das Data Warehouse haben sich weiterentwickelt. Wird im Standardwerk "Building a scalable Data Warehouse with Data Vault 2.0" noch ein transienter, flüchtiger Staging Layer beschrieben, ist im Lakehouse aufgrund der günstigeren Speicherkosten eine persistierte Staging Area (PSA) der Standard.
Data Lakehouse
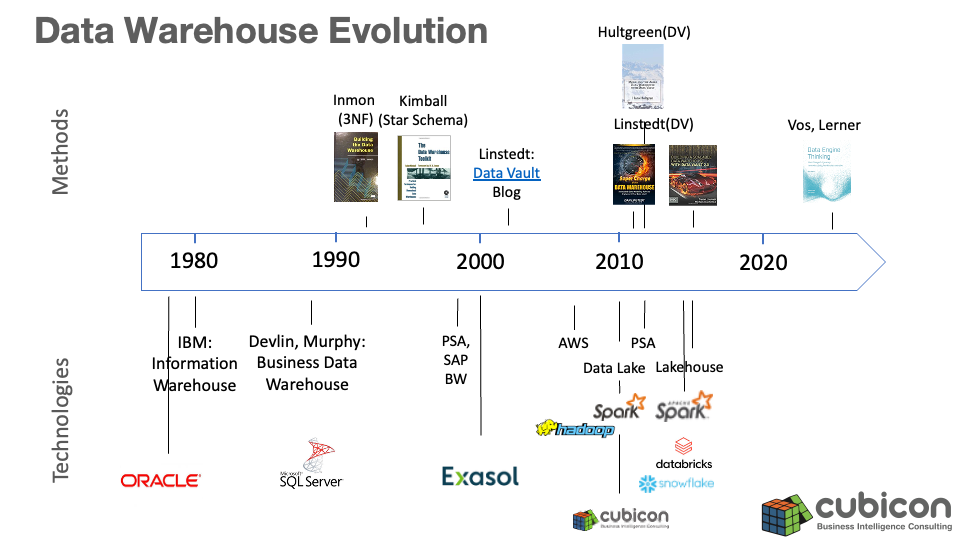
Ein Data Lakehouse ist eine moderne Datenarchitektur, die Flexibilität, Kosteneffizienz und Skalierbarkeit von Data Lakes mit Data Governance Funktionen und ACID-Transaktionssicherheit von Data Warehouses kombiniert. Es bildet eine einheitliche Datenplattform für Data Engineering, Data Streaming, maschinelles Lernen (ML), Business Intelligence (BI) und Künstliche Intelligenz (AI) Anwendungen.
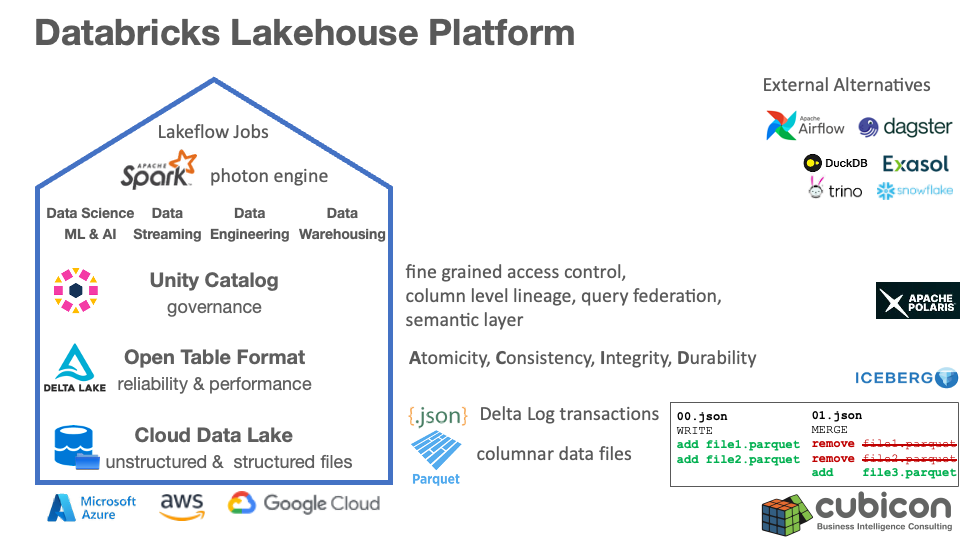
Basis für das Data Lakehouse ist ein Data Lake in einem Cloud Storage. Tabellen werden als Parquet Dateien in einem Verzeichnis gespeichert. Apache Parquet ist ein quelloffenes, binäres, spaltenorientiertes, schema-on-write Dateiformat, das speziell für die effiziente Speicherung und Analyse großer Datenmengen (Big Data) entwickelt wurde.
Delta Lake
Das quelloffenes Open Table Format Delta Lake legt eine transaktionale Metadatenschicht über die Parquet Dateien. Jede Transaktion wir im Delta Log als JSON Datei gespeichert. Beim Lesen der Tabelle wird zuerst im Delta Log geprüft, welche Parquet Dateien aktuell sind. Dadurch wird vor allem die Zuverlässigkeit von Transaktionen nach den ACID Kriterien garantiert (Atomicity, Consistency, Isolation, Durability).
Unity Catalog
Der Unity Catalog vereint Data Governance Funktionen. Er hat einen dreistufigen Namensraum:
catalog.schema.object
Fine-grained access control ermöglicht die dynamische Maskierung von vertraulichen Attributen und Filterung von Datensätzen mit Hilfe von Tags und Richtlinien.
Column-level lineage nutzt den SQL-Parser um Transformationsabhängigkeiten und die Herkunft der Daten als Metadaten zu extrahieren und grafisch darzustellen.
Lakehouse Federation (a.k.a. Datenvirtualisierung) ermöglicht den Zugriff auf externe Datenbanken ohne Datenmigration und technologieübergreifende Abfragen mittels Query-pushdown. Die Performance von Datenvirtualisierungslösungen hängt allgemein davon ab zu welchen Teilen eine Abfrage auf der externen Datenbank ausgeführt wird und nur die Ergebnisse zu Databricks gesendet werden. D.h. bei plattformübergreifenden Abfragen, die Databricks Tabellen mit der virtualisierten externen Datenbank verknüpfen, muss der Ausführungsplan mittels des EXPLAIN-Befehls kontrolliert werden. Außerdem muss sichergestellt sein, dass die angebundene Datenbank zusätzlich belastet werden darf.
Delta Sharing ermöglicht den sicheren Echtzeit-Datenaustausch über Unternehmens- und Plattformgrenzen hinweg auf Basis eines offenen Protokolls.
Metrics Views definieren den Semantic Layer mittels dimensionaler Metadaten für Text to SQL und agentic AI Zugriffe.
Spark Data Engine
Die Data- Engine Apache Spark ist ebenfalls quelloffen. Sie unterstützt die Sprachen SQL, Python, Scala, Java und R. Spark Structured Streaming basiert auf einer Kappa-Architektur und behandelt Datenströme genauso wie statische Tabellen. Mit der gleichen Codebasis können sowohl Streams als auch Batches verarbeitet werden. Databricks bietet zusätzlich die proprietäre in C++ geschriebene Photon- Engine an. Sie ist bei großen Datenmengen deutlich schneller aber auch teurer als die Spark- Engine, die in Scala geschriebenen ist und in der Java Virtual Machine läuft.
Lakeflow Jobs ist eine ausgereifte, nahtlos in die Databricks Platform integrierte Orchestrierung.
Multi-Plattform Lakehouse
Bei einer Multi-Plattform Strategie greifen verschiedene Data- Engines auf Tabellen im Open Table Format zu. Bei Databricks und Microsoft Plattformen ist Delta Lake der Standard. Bei anderen Engines ist meist Apache Iceberg der Standard. Databricks unterstützt ebenfalls Iceberg. Dafür wurde 2024 die Firma Tabular übernommen, die Iceberg erfunden hat. Der hohe Kaufpreis von über eine Milliarde USD für eine Firma mit 40 Mitarbeitern und 1 Million USD Umsatz unterstreicht die strategische Bedeutung des Iceberg Formats. Mit Databricks UniForm (Universal Format) können Delta-Lake-Tabellen automatisch auch als Apache-Iceberg Tabellen gelesen werden. Dafür werden zusätzlich die Iceberg- Metadaten generiert und als Iceberg-REST-Catalog-API bereitgestellt. D.h. die gleichen Parquet Dateien bekommen sowohl Delta Lake als auch Iceberg Metadaten. Sollen externe Engines auch nach Iceberg schreiben, so ist das Iceberg Table Format notwendig:
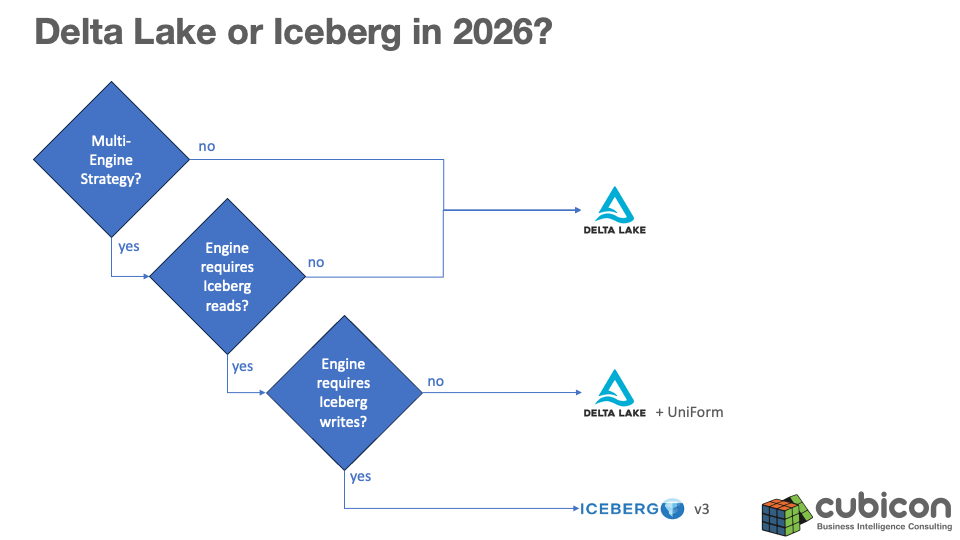
Bei einer Multi-Plattform Strategie sind auch externe Orchestierungen und Kataloge ein Thema wie z.B. Apache Airflow, Dagster und Apache Polaris.
Architektur
Databricks verwendet die Medallion-Architektur (Multi-Hop Architektur) zur logischen Strukturierung von Daten im Lakehouse:
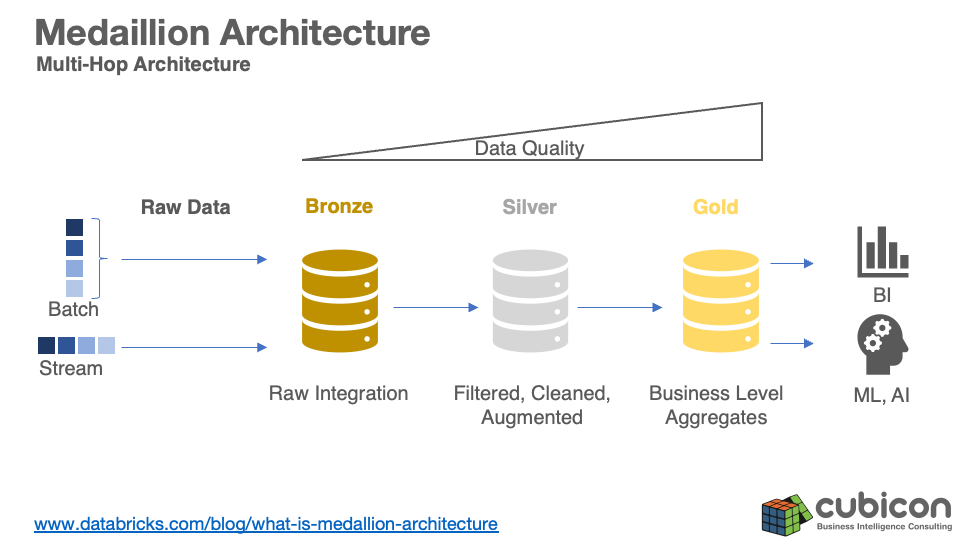
Die Methoden Data Vault und Data Engine Thinking unterscheiden strikt zwischen vorhandenen Daten und interpretierten, abgeleiteten Daten. Der Business Vault bzw. die Derived Integration Area füllt die Lücke zwischen der Nachfrage nach Informationen und dem Angebot an vorhanden Daten aus den Quellsystemen. Diese Trennung hat sich bewährt und ist Konsens in der Data Vault Community, da sich die Interpretation der Daten öfter ändert als die "operative Realität" (System of Record) der Quellsysteme mit möglichen Datenqualitätsproblemen. Für manche Analysen sind jedoch genau diese uninterpretierten Rohdaten des Raw Vaults hilfreich. Es entspricht dem Architekturprinzip "Trennung der Zuständigkeiten" (Separation of Concerns) .
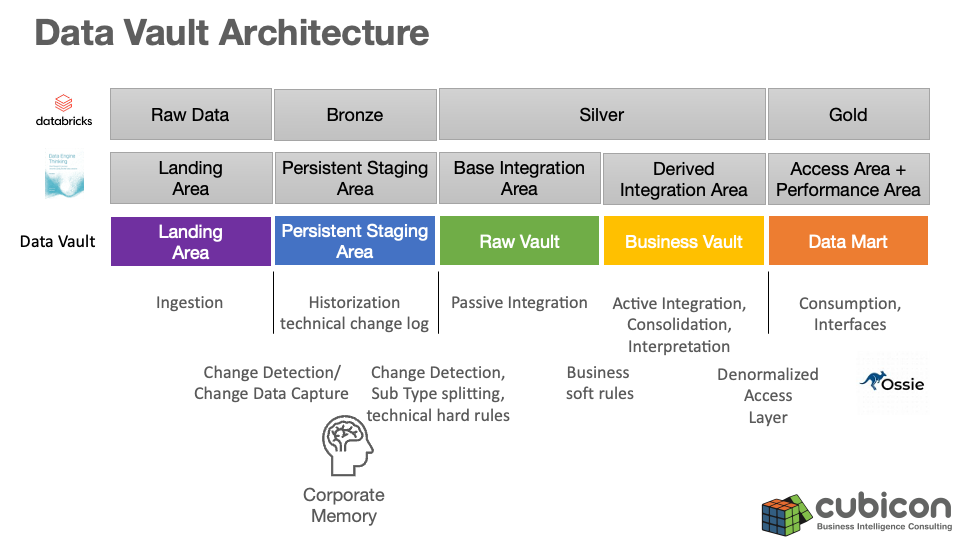
Landing Area
Dateianlieferungen landen in einem Verzeichnis im Cloud Data Lake. Databricks Auto Loader übernimmt diese automatisch und speichert die Änderungen in der Persistent Staging Area. Es gibt zwei Modi um von neuen Dateien zu erfahren:
| Modus | Directory Listing | File Notification |
|---|---|---|
| Funktionsweise | Cloud-Verzeichnis regelmäßig scannen | Cloud-eigene Event-Dienste benachrichtigen Auto Loader automatisch bei neuen Dateien. |
| Einrichtung | nicht notwendig | Benötigt Berechtigungen zum Erstellen von Cloud-Queues und Benachrichtigungsdiensten. |
Für Streaming Systeme wie Kafka gibt es den Kafka Connector. Databricks baut die Ingestion-Konnektoren laufend aus und bietet unter anderem Change Data Capture (CDC) Konnektoren für Oracle, MS SQL Server, MySQL und Postgres an.
Persistent Staging Area (PSA)
Die PSA ist ein technischer Event-Log für alle Ereignisse die im Unternehmen angefallen sind. Sie bringt alle angelieferten Systeme in ein einheitliches, technisch historisiertes Format (SCD2), ähnlich eines Change Data Capture Systems bzw. eines Cold Stores für einen Event- Log- Stream. Ziel ist eine schnelle, einfache Anbindung und Historisierung der angebundenen Systeme ohne komplexe Business-Key-Analyse oder Datenmodellierung. Der eindeutige Schlüssel besteht zumindest aus einem eindeutigen Schlüssel der Quelle und einem technischen Zeitstempel der Anlieferung. Dieser technische Zeitstempel bildet die High Watermark für inkrementelle Ladeprozesse bzw. Streaming in die nachfolgenden Schichten. Die PSA bildet das Unternehmensgedächtnis und die Absicherung für die Datenplattform. Tabellen der oberen Schichten können mittels "Replay" der Historie aus der PSA erzeugt werden.
Der Vorteil der PSA mit "Replay"- Funktionalität liegt in der schnellen Anbindung der Quellsysteme: Trotz einer schrittweisen Entwicklung von Datenmodell und Geschäftslogik steht die komplette Historie ab Anbindung jederzeit im aktuellen Softwarestand bereit.
Quellsysteme liefern idealerweise inkrementell ein echtes Delta mit Änderungskennzeichen für insert, update oder delete, ähnlich einem Change Data Capture System. Wenn die Quelle einen Vollabzug (Snapshot) liefert, wird über die Änderungserkennung das einheitliche, inkrementelle Delta Format für die PSA erzeugt.
| TSA vs. PSA | Transient Staging Area | Persistent Staging Area |
|---|---|---|
| Historisierungsbeginn | Anbindung des Quellsystems | nach Analyse und Modellierung |
| Go-Live Datenstand | Historie aus der PSA | Historie aus Raw Vault Implementierung |
| Zeitreihenbeginn | konsistent | inkonsistent |
| Speicherbedarf | höher | geringer |
| Data Profiling | volle Historie | Snapshot |
| Refactoring | einfach, mittels PSA replay | teuer, mittels Migrationsskripte |
Raw Vault
Im Raw Vault werden PSA Tabellen nach der Data Vault Methode zerlegt und über gemeinsame Business Keys passiv in den Hub integriert. Auf Besonderheiten der bi-temporalen Historisierung gehe ich in dieser Übersicht nicht ein.
Business Vault
Da ein Unternehmen mehr Informationen benötigt als in den Quellsystemen vorhanden ist, müssen diese im Business Vault abgeleitet werden. Der Business Vault hat die gleiche Struktur wie der Raw Vault. Er konsolidiert gleiche Attribute aus verschiedenen Quellen und berechnet abgeleitete Attribute.
Data Mart
Der Data Mart Layer implementiert ein dimensionales Star Schema und ist auf einfachen Zugriff und Self Service Analysen für den Fachbereich optimiert. Für maximale Performance wird im Lakehouse das Star Schema zu einer einzigen Tabelle denormalisiert (One Big Table, Flat Wide Table).
Fachliche Datenmodellierung
Die Geschäftsprozesse in einem Unternehmen laufen über mehrere Systeme mit unterschiedlichen Datenmodellen und und teilweise überlappenden Dateninhalten.
Business Keys identifizieren Geschäftsobjekte systemübergreifend und sind die Basis für die Datenintegration in ein einheitliches, fachliches Datenmodell, das Business Data Model.
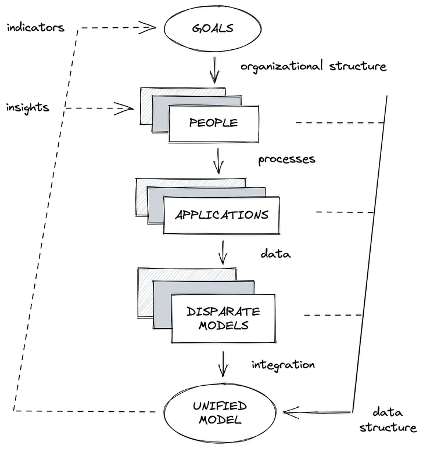
Grafik: ©️ Lars Rönnbäck modelyourreality.substack.com/p/towards-a-model-driven-organization-part-1
Das Business Data Model ist ein konzeptionelles, fachliches Modell. Es standardisiert die fachliche Sprache und Begriffe des Unternehmens, vereinheitlicht verschiedene Quellsystemmodelle und ermöglicht stabile Analysen über eine dynamische, vielfältige Systemlandschaft.
Business Data Model Driven Data Warehouse Automation
Automatisierungsprozess
Der Automatisierungsprozess beginnt mit einem Workshop mit dem Fachbereich wo die Geschäftsobjekte einer fachlichen Domäne (a.k.a. Datenbereich, Geschäftsbereich, Subject Area) und deren Beziehungen identifiziert werden. Das Ergebnis ist ein konzeptionelles, fachliches Business Data Model in dem fachliche Namen für die Geschäftsobjekte (a.k.a. Hubs, Entities) und deren Beziehungen vergeben werden.
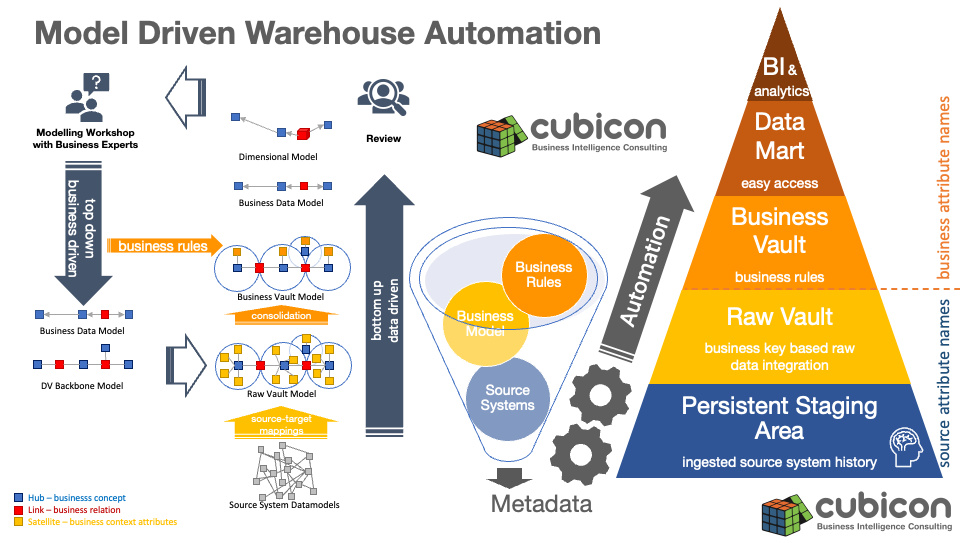
Aus dem fachlichen Modell wird durch einfache Zerlegungsregeln (Normalisierungsregeln) das Data Vault Backbone Modell abgeleitet. Das Netzwerk aus Hubs und Links bildet das fachliche Rückgrat des Data Vault Models.
Danach werden die Quellsystemtabellen der fachlichen Domäne identifiziert. Für jede Tabelle werden der fachliche Business Keys und fachliche Beziehungen zu anderen Tabellen ermittelt und dem fachlichen Modell als Source- Target- Mapping zugeordnet. Mit diesen Metadaten werden Hubs, Links und Satelliten des Raw Vaults geladen.
Der Business Vault konsolidiert Raw Vault Satellitenattribute aus verschiedenen Quellsystemen und berechnet mittels fachlichen Geschäftsregeln abgeleitete Attribute.
Im Data Mart Layer wird der Data Vault zu Fakten und Dimensionen bzw. noch weiter zu One Big Tables zusammengefasst (denormalisiert).
Für die agile Feedback-Loop und Kontrolle des Projektfortschritts ist es wichtig Ergebnisse als Datenprodukt zu veröffentlichen. Verbesserungsvorschläge aus dem fachlichen Review werden unmittelbar in einer weiteren Iteration umgesetzt.
Ein top down Ansatz der mit einem konzeptionellen, fachlichen Modell beginnt führt zu nachhaltigen Ergebnissen. Die Systemlandschaft eines Unternehmens ändert sich, Systeme werden mit der Zeit ersetzt und abgelöst. Erfolgt die Umsetzung rein bottom up und data driven führen Änderungen in der Systemlandschaft zu hohen Kosten und instabilen Datenprodukten. Die den Geschäftsprozessen zugrunde liegenden fachlichen Konzepte sind stabiler als die Quellsysteme, die die Geschäftsprozesse unterstützen. Durch eine Automatisierung auf Basis des fachlichen Datenmodells bleibt das Data Lakehouse stabil und offen für Änderungen. Es wächst mit dem Unternehmen mit und muss nicht bereits nach wenigen Jahren wieder abgelöst werden.